클로드 코드에게 큰 프로젝트를 통째로 맡기면, 한 세션이 한꺼번에 기억할 수 있는 양인 컨텍스트 윈도우를 금세 넘어선다. 퇴근 후 짬을 내 투자 보조 도구를 만들면서 나는 이 벽을 피하려고 일을 카드 한 장 크기로 자르고, 카드마다 클로드 코드 서브에이전트를 새로 띄워 맡겼다. 2026년 9월 19일 이 방식을 처음 돌린 뒤 엿새 동안 카드 42장이 닫혔다.
이 글에는 카드를 자르는 기준, 서브에이전트에게 구현과 검사를 나눠 주는 방법, 그리고 시험을 통과하고도 틀렸던 자리를 적었다.
먼저 결론
큰 프로젝트를 AI에게 맡길 때 결과를 믿게 해 준 것은 모델의 실력보다 일을 나누는 방식이었다.
한 세션 안에서 끝나는 크기로 자른 카드, 구현한 쪽 손이 닿지 않게 둔 채점 기준, 실제 데이터가 처음 도는 자리에서 사람이 멈춰 보는 칸.
시험을 통과한 코드가 틀렸다는 사실은 실제 데이터 앞에서야 드러났다.
기획자가 클로드 코드로 투자 도구를 만드는 이유
나는 미디어아트를 전공했고 개발도 해 봤지만, 지금은 회사에서 기획 일을 한다. 코드를 짜기보다 문제를 정의하는 사람이라, 내 문제를 정의하고 빠르게 풀어 보는 도구로 클로드 코드를 쓴다.
클로드 코드(Claude Code)는 Anthropic이 만든 AI 코딩 도구로, 터미널에서 내 프로젝트 폴더의 파일을 직접 읽고 고치고 명령을 실행한다. 회사에서 이 도구로 기획 프로세스를 다시 설계해 본 경험이 있었고, 그 경험이 멈춰 있던 투자를 다시 시작한 계기가 됐다.
내가 풀고 싶은 문제는 투자였다. 배운 매매 방법론을 지키려면 매일 저녁 전 종목을 훑고 다음 날 계획을 세워야 하는데, 아이들을 키우는 직장인에게는 그럴 시간이 없다. 그래서 데이터를 모아 판정하는 일은 도구에 맡기고, 나는 저녁에 계획을 확정하는 20분만 앉기로 했다. 장중의 주문과 감시도 도구에 맡기려 한다.
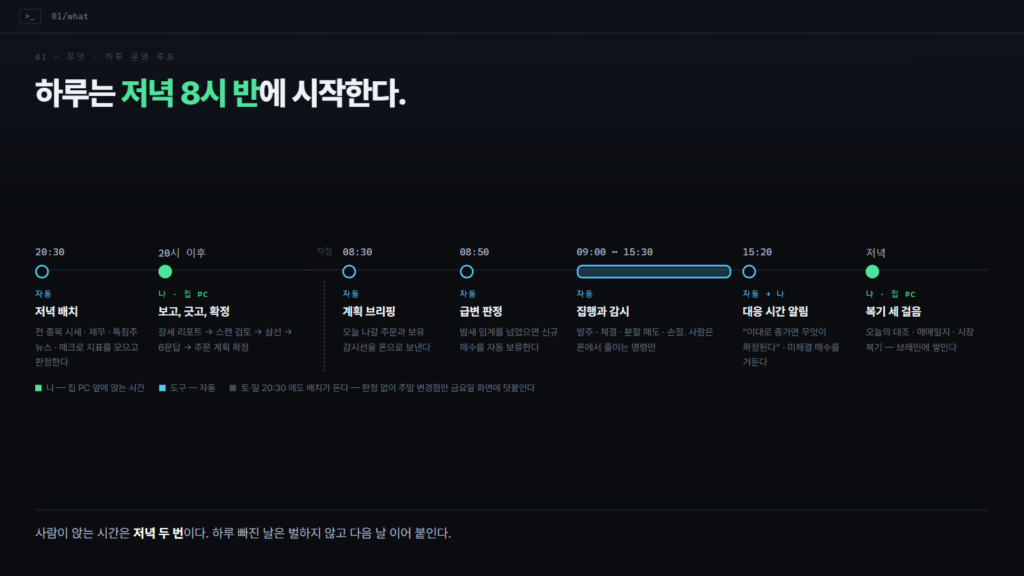
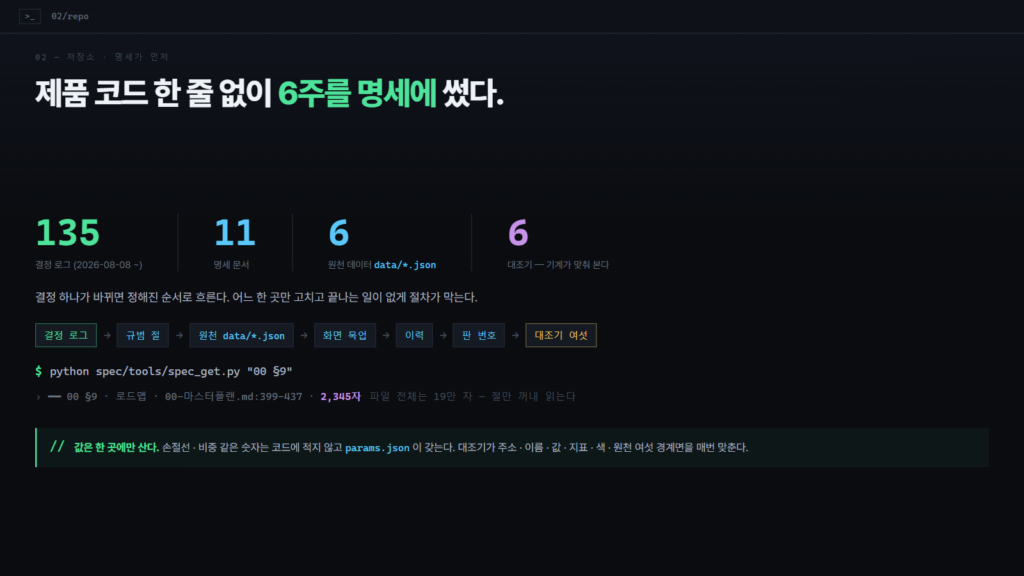
그래서 코드를 쓰기 전 6주 동안 클로드 코드와 함께 결정 130건 남짓을 명세 문서에 적었다. 어떤 데이터를 어디서 받고, 판정은 어떤 규칙으로 하며, 화면에는 무엇을 띄울지 말이다.
큰 프로젝트는 컨텍스트 윈도우 하나에 들어가지 않는다
컨텍스트 윈도우는 AI가 한 세션에서 한꺼번에 기억할 수 있는 분량이다. 읽은 파일, 주고받은 대화, 실행 결과가 전부 이 창에 쌓인다. 창이 차면 클로드 코드는 앞의 대화를 요약해 압축한 뒤 이어 가는데, 그 요약 과정에서 앞서 정한 세부가 빠지기 쉽다.
구현을 시작하려던 날 이 벽이 눈앞에 있었다. 클로드 코드는 내 폴더의 문서를 직접 읽으니 명세를 대화창에 붙여 넣을 필요는 없었다. 문제는 양이었다. 명세는 문서 열한 개로 나뉘어 있었고, 가장 큰 파일 하나가 19만 자였다. 기능 하나를 만들려면 여러 파일을 오가야 해서 비효율적이었고, 그렇다고 하나로 합치면 파일 하나 읽는 데 토큰을 다 써 버릴 것 같았다.
답은 읽는 단위를 바꾸는 데 있었다. 기능 하나에 필요한 것은 명세 전체가 아니라 절 몇 개뿐이니까. 문서를 절 단위로 꺼내 읽는 작은 도구를 만들고, 일 하나에 필요한 절의 주소만 적어 넘기기로 했다.
카드는 거기서 나왔다. 카드는 서브에이전트 한 세션이 컨텍스트 윈도우를 넘지 않고 끝낼 수 있는 크기의 일 하나다. 큰 프로젝트를 이런 카드로 잘게 나눠 두면 세션이 바뀌어도 전체는 이어진다. 어디까지 했는지는 대화가 아니라 장부 파일(카드 목록과 상태를 적은 파일)과 git에 남기 때문이다.
원하는 결과를 제대로 얻으려면 한 세션 안에서 잘 묻는 것만으로는 모자랐다. 프롬프트를 다듬고, 무엇을 읽힐지 고르는 컨텍스트 엔지니어링, 일하는 환경과 검사를 짜는 하네스 엔지니어링, 같은 절차를 되풀이하는 루프, 결과에 따라 다음 길이 갈리는 그래프까지 이 카드 루프에는 다 들어 있다.
도구는 수집, 기록, 화면, 주문 같은 구성물로 나뉜다. 카드는 이 구성물 사이의 경계 하나만 다루도록 잘랐다.

클로드 코드 서브에이전트는 카드 한 장마다 새로 뜬다
서브에이전트는 자기 컨텍스트 윈도우에서 따로 일하고 결과만 메인 세션에 돌려주는 클로드 코드의 기능이다(공식 문서). 창이 따로 있으니 서브에이전트가 파일을 읽고 시험을 돌린 흔적은 메인 세션에 쌓이지 않는다. 카드마다 서브에이전트를 새로 띄우면, 카드마다 깨끗한 창 하나로 시작하는 셈이다.
첫 카드는 2026년 9월 19일 밤 11시가 다 되어 돌렸다. 프로젝트의 뼈대와 관문 자체를 세우는 카드라, 서브에이전트가 무엇을 읽고 무엇을 쓰는지 옆에서 하나하나 지켜봤다. 그 뒤로는 사람이 확인할 자리가 나올 때까지 루프가 혼자 돈다.
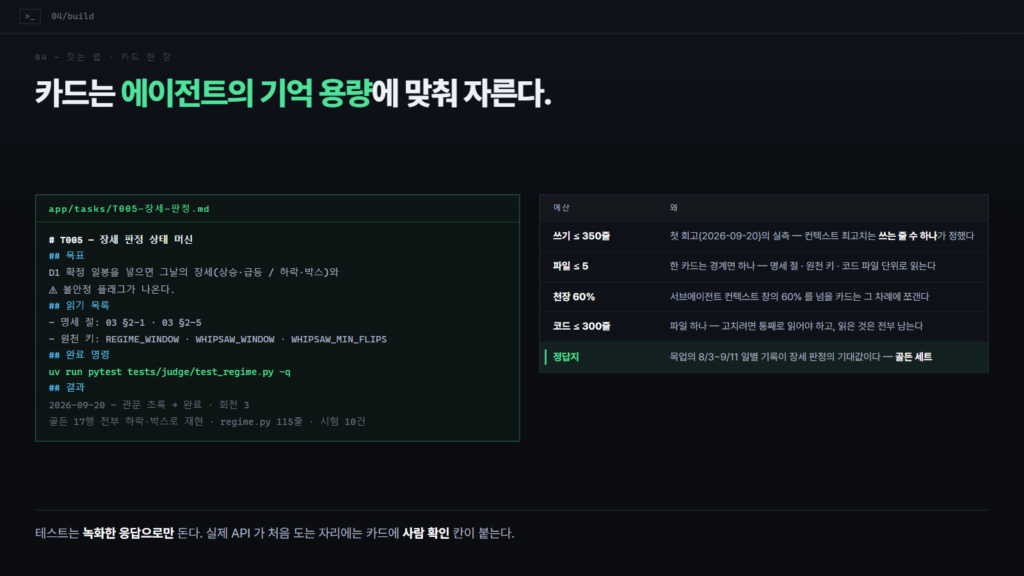
카드 한 장에는 목표 한 문장, 읽을 명세 절의 주소, 다 됐는지 확인하는 완료 명령, 그리고 사람이 확인할 자리가 있는지가 적혀 있다.
카드가 도는 동안 메인 세션(큰 모델인 Opus)은 코드를 열지 않는다. 장부에서 다음 카드를 꺼내 그 경로를 서브에이전트에게 넘기고, 관문을 돌려 통과하면 커밋하는 것이 메인 세션의 일이다.
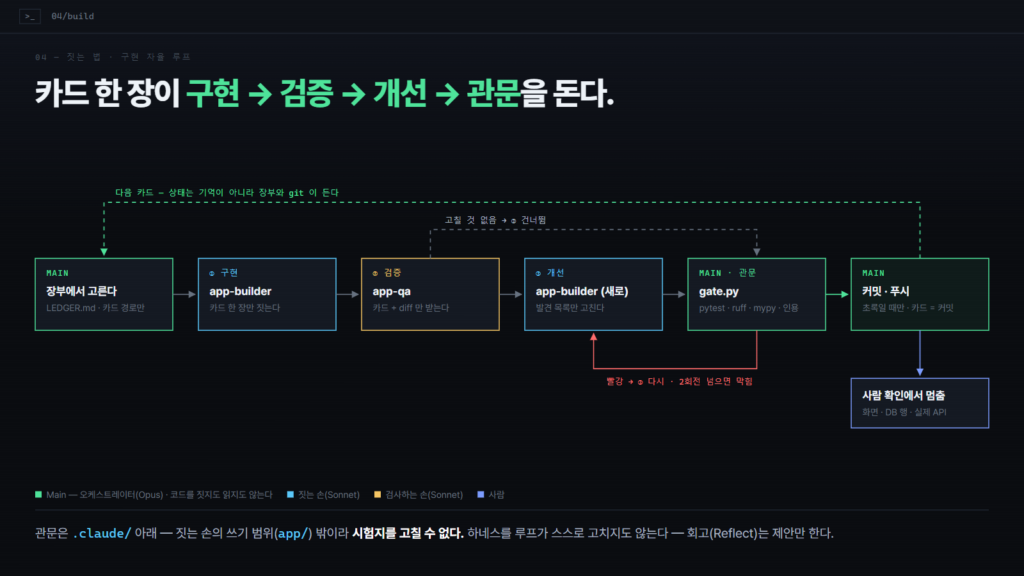
구현을 맡은 서브에이전트는 카드 한 장만 받아 코드를 쓴다. 검사를 맡은 서브에이전트는 카드와 바뀐 코드(diff)만 받는다. 구현한 쪽이 남긴 설명은 일부러 넘기지 않는데, “이렇게 했으니 맞습니다”라는 말을 먼저 읽으면 검사가 그 말을 따라가 버리기 때문이다. 고칠 것이 나오면 서브에이전트를 하나 더 새로 띄워 발견 목록만 고치게 한다.
그다음은 관문이다. 시험(pytest)과 서식·타입 검사, 문서 인용 검사, 카드의 완료 명령을 스크립트 하나가 차례로 돌린다. 모두 통과해야 메인 세션이 커밋하고, 카드 한 장이 커밋 하나가 된다. 실패하면 고치는 서브에이전트에게 되돌아가고, 두 번 돌아도 안 되면 그 카드는 막힘으로 남긴다.
관문 스크립트는 구현하는 서브에이전트가 쓸 수 있는 app/ 폴더 밖, .claude/ 아래에 두었다. 카드의 완료 명령도 구현하는 쪽이 고치지 않게 해 두었다. 채점 기준을 채점받는 쪽이 건드리지 못하게 한 것이다. 다만 시험 코드와 시험 데이터는 구현하는 서브에이전트가 직접 쓰는데, 첫 사고는 바로 이 틈에서 났다.
컨텍스트 사용량을 정한 것은 쓰는 줄 수였다
처음에는 카드를 자를 때 읽을 문서의 글자 수, 읽을 코드의 줄 수, 쓸 코드의 줄 수에 각각 상한을 매겼다. 서브에이전트가 컨텍스트 윈도우를 어디까지 써도 되는지는 처음에 40%로 잡았다가, 같은 날 60%를 천장으로 올렸다.
그런데 네 번째 카드에서 계산이 틀어졌다. 상한은 전부 지켰는데, 구현한 서브에이전트가 컨텍스트의 80%를 쓴 것이다. 기준을 지켰는데 천장을 뚫었으니 기준 자체가 틀린 셈이었다.
앞서 돌린 카드들을 나란히 놓고 나서야 이유가 보였다. 사용량을 정한 것은 읽는 양이 아니라 쓰는 줄 수였다. 120줄을 쓴 카드는 18%, 280줄은 38%, 320줄은 52%, 480줄은 80%. 거의 직선이다.
한 줄에 약 330토큰이 들었으니, 파일에 남는 글자의 26배쯤이다. 그 차이는 한 줄에 이르기까지의 왕복에서 나온다. 시험을 돌린 출력, 고친 코드, 다시 돌린 결과가 모두 창에 쌓이니까. 80%를 쓴 카드는 그사이 응답을 39번이나 주고받았으니 말이다.
그 뒤로 예산 표에서 천장을 정하는 칸은 “코드와 시험을 합쳐 350줄” 하나로 좁혔다. 넘을 것 같은 카드도 미리 쪼개 두지 않고, 그 차례가 왔을 때 쪼갠다. 앞 카드가 드러낸 사실이 뒤 카드의 모양을 바꾼 적이 여러 번 있었기 때문이다.
시험을 통과했는데 지수가 100배였다
루프를 돌린 첫 월요일 저녁, 증권사 서버에서 지수를 처음으로 실제로 받아 봤다. 관문도 통과했고 검사 결과도 ‘고칠 것 없음’이었던 코드다. 그런데 지수에 100이 한 번 더 곱해져 있었다. 통과 표시만 믿고 넘어갔다면 그대로 쌓였을 숫자다.
원인은 시험이 먹던 데이터에 있었다. 서버 응답을 녹화해 두고 그걸로 시험을 돌리는데, 그 녹화를 구현한 서브에이전트가 직접 만들었다. 실제 응답이 아니라 그럴듯하게 지어낸 숫자였으니, 시험은 지어낸 숫자를 상대로 맞게 통과했을 뿐이다. 지수 단위가 어떻게 어긋났는지는 키움 REST API 종가가 HTS와 다른 이유에 자세히 적었다.
그래서 녹화는 구현하는 쪽에 맡기지 않기로 했다. 카드를 쪼갤 때 메인 세션이 실제 서버에서 응답을 떠서 카드에 붙여 둔다. 덤도 있었다. 녹화를 직접 뜨던 카드는 컨텍스트를 65~75%씩 썼는데, 녹화를 미리 실어 준 카드 한 장은 36%로 끝났다.
빈칸을 추측으로 메우는 일도 있었다. 명세에 이미 정해 둔 이름이 있는데 새 이름을 지어 붙였고, 명세가 정하지 않은 상한가 기준을 29%라는 근삿값으로 때우면서 엉뚱한 과제 번호를 달아 두기도 했다. 그 뒤로 명세에 없는 것은 지어내지 말고 멈춘다는 규칙을 분명히 적었다. 멈춘 카드는 막힘으로 남고, 명세를 채우는 건 내 몫이다.
이런 규칙은 카드가 여러 장 돈 뒤의 회고에서 나온다. 회고는 근거 카드 번호를 붙여 제안만 하고, 어떤 제안을 받을지는 내가 고른다.
틀린 것은 코드가 아니라 명세였다
카드를 쪼갤 때 칸 하나를 더 적는다. 실제 API가 처음 도는 자리, 화면에 처음 무언가가 뜨는 자리, DB에 실제 행이 처음 쌓이는 자리에는 사람 확인 칸을 붙인다. 이 칸이 찬 카드는 관문을 통과해도 루프가 거기서 멈추고 나를 기다린다.
그날 상한가로 마감한 종목을 골라내는 카드가 그랬다. 시험도 검사도 통과했고, 코드는 명세에 적힌 대로 지어져 있었다. 그런데 증권사 HTS의 상한가 화면을 띄워 결과와 나란히 놓으니 하나가 비었다. 정규장에서는 10%대 상승으로 끝났지만, 장이 끝난 뒤에도 저녁 8시까지 이어지는 대체거래소 넥스트레이드 거래에서 상한가를 찍은 종목이었다.
명세는 종가를 정규장 값으로 정해 두면서도, 상한가를 가르는 절에서는 장 마감 뒤의 거래를 따로 다루지 않았다.
이럴 때 카드는 “카드대로는 맞게 지어졌다”로 닫고, 명세를 먼저 고친 뒤 고침 카드를 새로 붙인다. 아래 장부의 24장이 나흘 뒤 55장으로 늘어난 데는 이런 고침 카드와, 너무 커서 쪼갠 카드가 적잖이 섞여 있다.
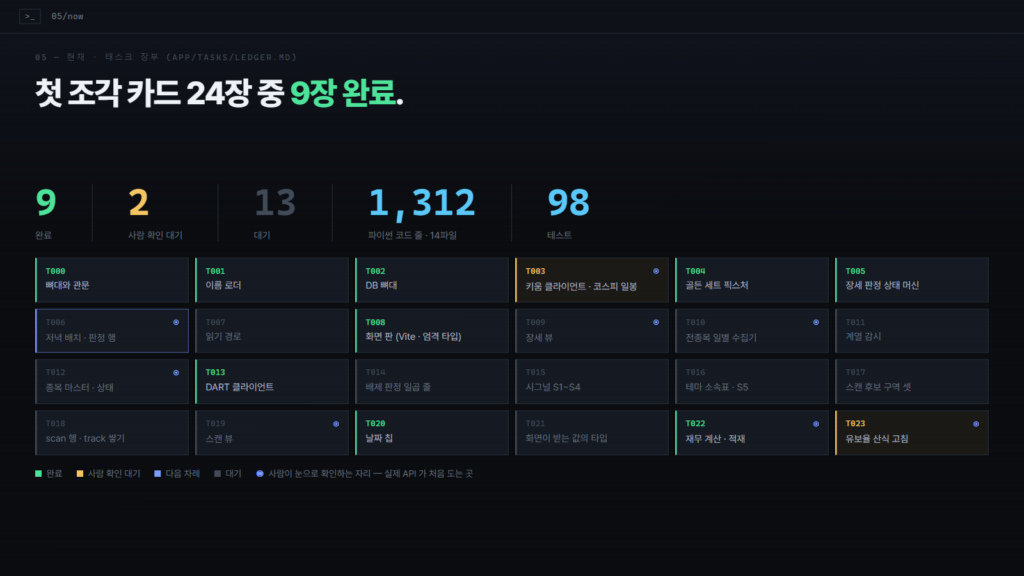
엿새 동안 카드 42장, 주문 코드는 아직 없다
2026년 9월 25일 현재 장부에는 카드 55장이 있고, 그중 42장이 닫혔다. 2장은 내가 확인할 차례를 기다리고, 11장은 아직 차례가 오지 않았다. 제품 코드는 파이썬 4,266줄이고, 시험 코드가 그보다 긴 6,197줄이다.
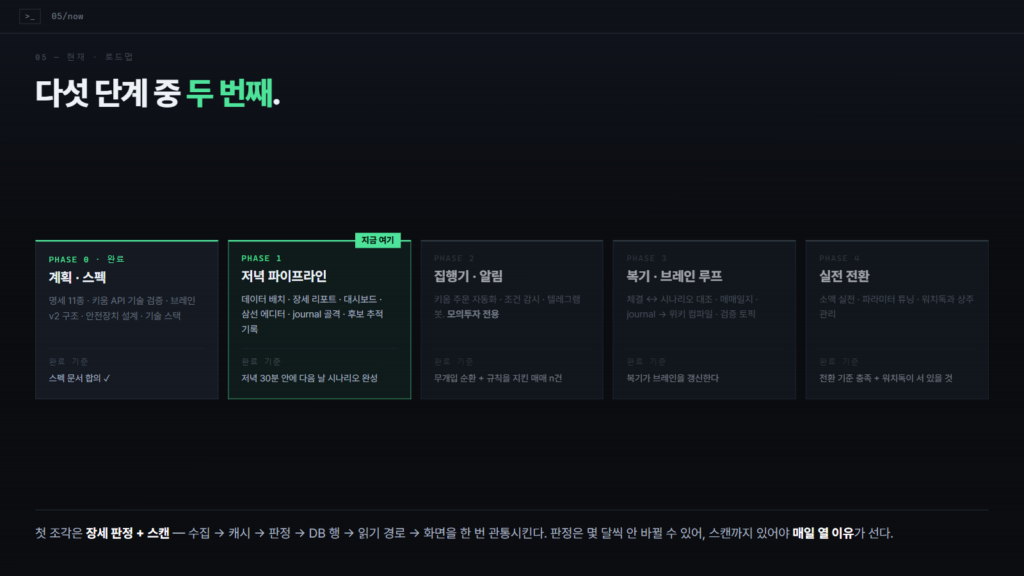
아직 주문을 내는 코드는 한 줄도 없다. 다섯 단계 가운데 두 번째를 짓는 중이고, 주문 단계로 넘어갈 때는 검사를 맡은 서브에이전트를 더 센 모델로 올릴지 다시 정하려 한다. 돈이 오가는 자리에서까지 구현과 같은 급의 검사를 믿어도 될지는 아직 모르겠다.
시험이 녹화한 응답으로만 돈다는 한계도 그대로라, 증권사가 응답 모양을 바꾸면 사람 확인 칸에 가서야 드러난다. 회고가 규칙을 하나씩 보태며 절차가 무거워지는 것도 마음에 걸린다.
무엇을 어디까지 만들었는지는 RichRich 프로젝트 페이지에 정리해 두고 있다. 실제 데이터 앞에서 설계가 처음 틀렸던 이야기는 KRX API 종가가 증권사 화면과 달랐던 기록에 따로 적었다.
큰 일을 AI에게 맡길 때 먼저 정할 것은 한 세션에 무엇을 맡기지 않을지다. 컨텍스트 윈도우 안에서 끝나는 만큼만 자르고, “다 됐습니다”는 실제 데이터로 확인한다.
이 글의 요약
클로드 코드에게 큰 프로젝트를 맡기면서, 한 세션의 컨텍스트 윈도우 안에서 끝나는 크기로 일을 카드 한 장씩 잘랐다.
카드마다 서브에이전트를 새로 띄워 구현과 검사를 서로 다른 세션에 맡기고, 진행 상태는 장부 파일과 git에 남겼다.
서브에이전트의 컨텍스트 사용량은 읽는 양이 아니라 쓰는 줄 수가 정했고, 한 줄에 약 330토큰이 들었다.
자주 묻는 것
클로드 코드 서브에이전트는 언제 쓰면 좋나?
한 세션에 다 담기지 않는 큰 작업을 나눌 때, 그리고 만드는 쪽과 검사하는 쪽을 가르고 싶을 때다. 서브에이전트는 자기 컨텍스트 윈도우에서 일하고 결과만 돌려주니 메인 세션의 창이 차지 않는다. 검사하는 서브에이전트에게 구현한 쪽의 설명을 주지 않으면, 설명에 끌려가지 않고 카드와 코드만 맞춰 본다.
클로드 코드 컨텍스트 윈도우가 다 차면 어떻게 하나?
나는 다 차기 전에 끊는 쪽을 택했다. 일을 한 세션 안에서 끝나는 카드로 자르고, 어디까지 했는지는 대화가 아니라 장부 파일과 git에 남긴다. 그러면 세션이 바뀌어도 장부에 남은 다음 카드부터 이어 갈 수 있다.
카드는 어떤 크기로 잘라야 하나?
내 경우에는 쓰는 줄 수가 기준이었다. 코드와 시험을 합쳐 350줄을 넘을 것 같으면 쪼갠다. 읽을 문서의 양은 컨텍스트 사용량과 거의 상관이 없었다.
이 기록을 쓰는 사람에 대해서는 소개에 적어두었다.
- 이 글은 개인의 학습·개발 기록이며 투자 권유가 아닙니다.
- 투자 판단과 그 결과는 투자자 본인에게 있습니다.